广告素材自审平台:让 AI 在每个环节先审一遍
今天把系统完善上线了,做了这么一个功能使用文档。
一句话说清它干什么:在广告素材制作的每个环节(脚本、制作、剪辑),都让员工先用 AI 系统自审一遍,减少把错误遗留到下一环节直至成片的概率。人工审核的压力小了,成片过审率也上去了。
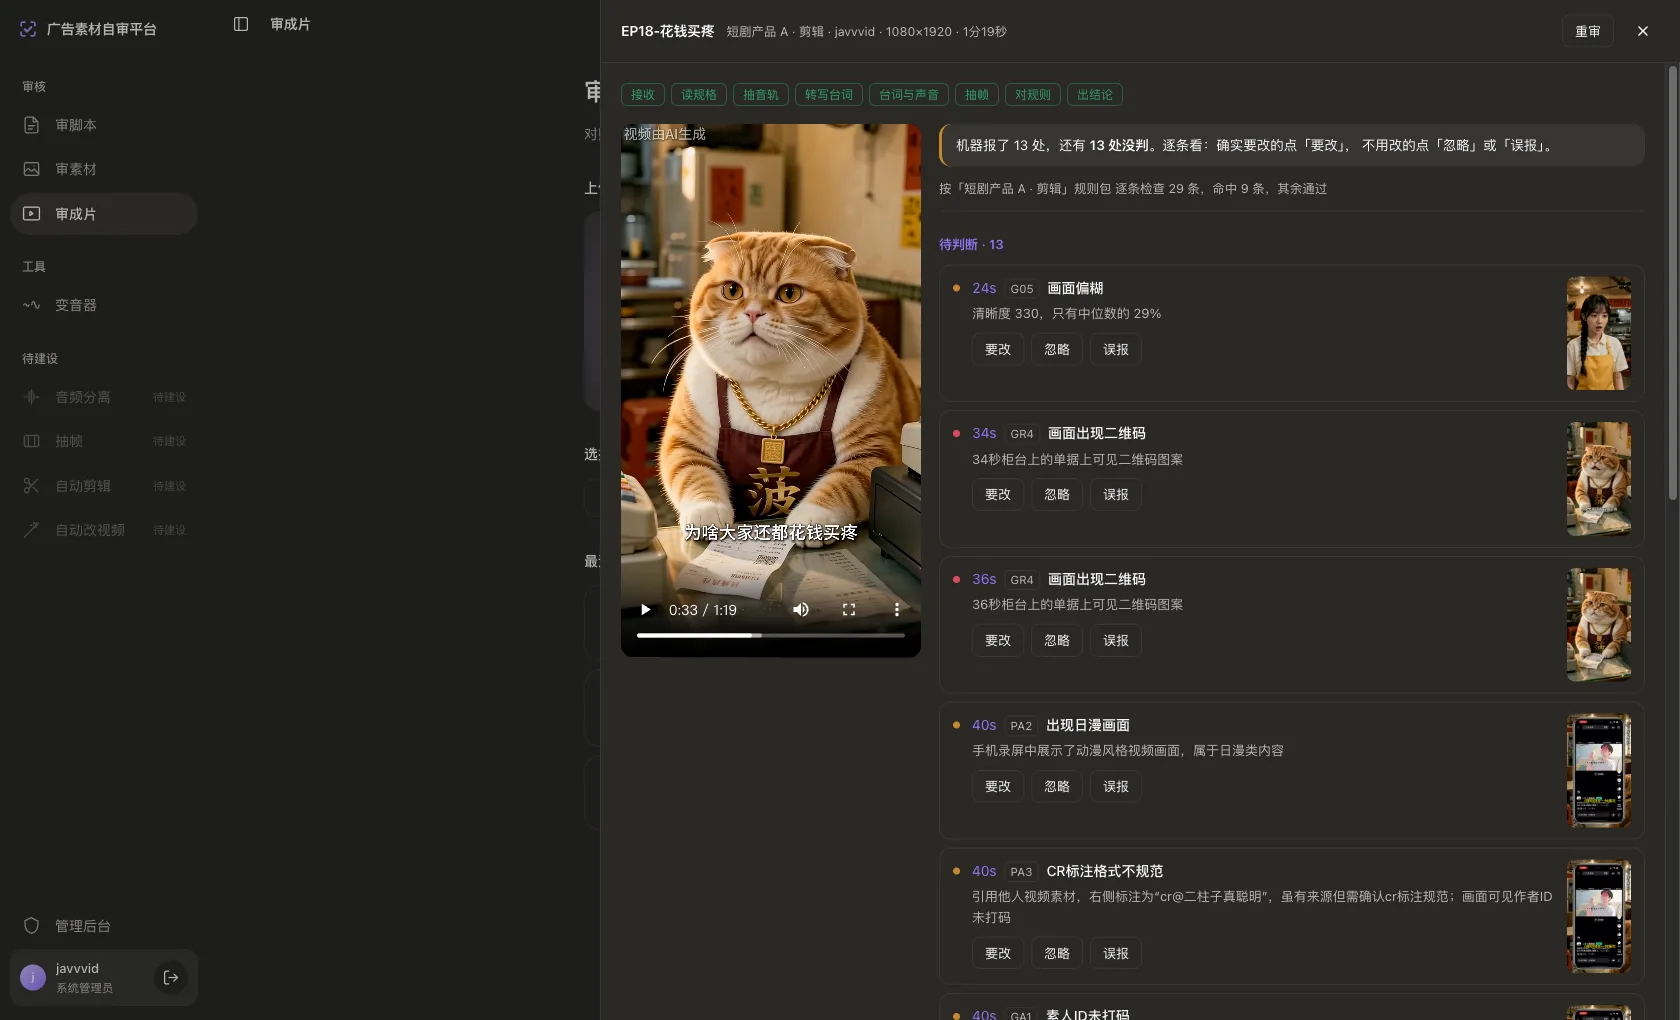
一条成片审完的样子:左边原片,右边逐条结论,每条配证据帧
一、为什么要做这个
以前:常规流程每个环节也有自审,但员工自审能力参差不齐,很多明显的错误还是被提交到了人工审核。甚至同一个错误反复犯——一个人犯一遍,换个人又犯一遍。提交被驳回,改完再交,来回好几轮。审核这一关全压在人工审核那一个人身上,既增加他的压力,又降低整体效率。真提交给客户,就是损失。
现在:每个环节多一道 AI 系统自审,交给下一环之前先过一遍,改完再提交。明显的、易错的问题在成片提交之前就被过滤掉。
而且系统有循环进化:如果经过自审和修改之后仍有错误,那条意见可以回传给系统,下次它会提前拦住。
第一版设计了三个环节的自审。
审脚本 · 编导
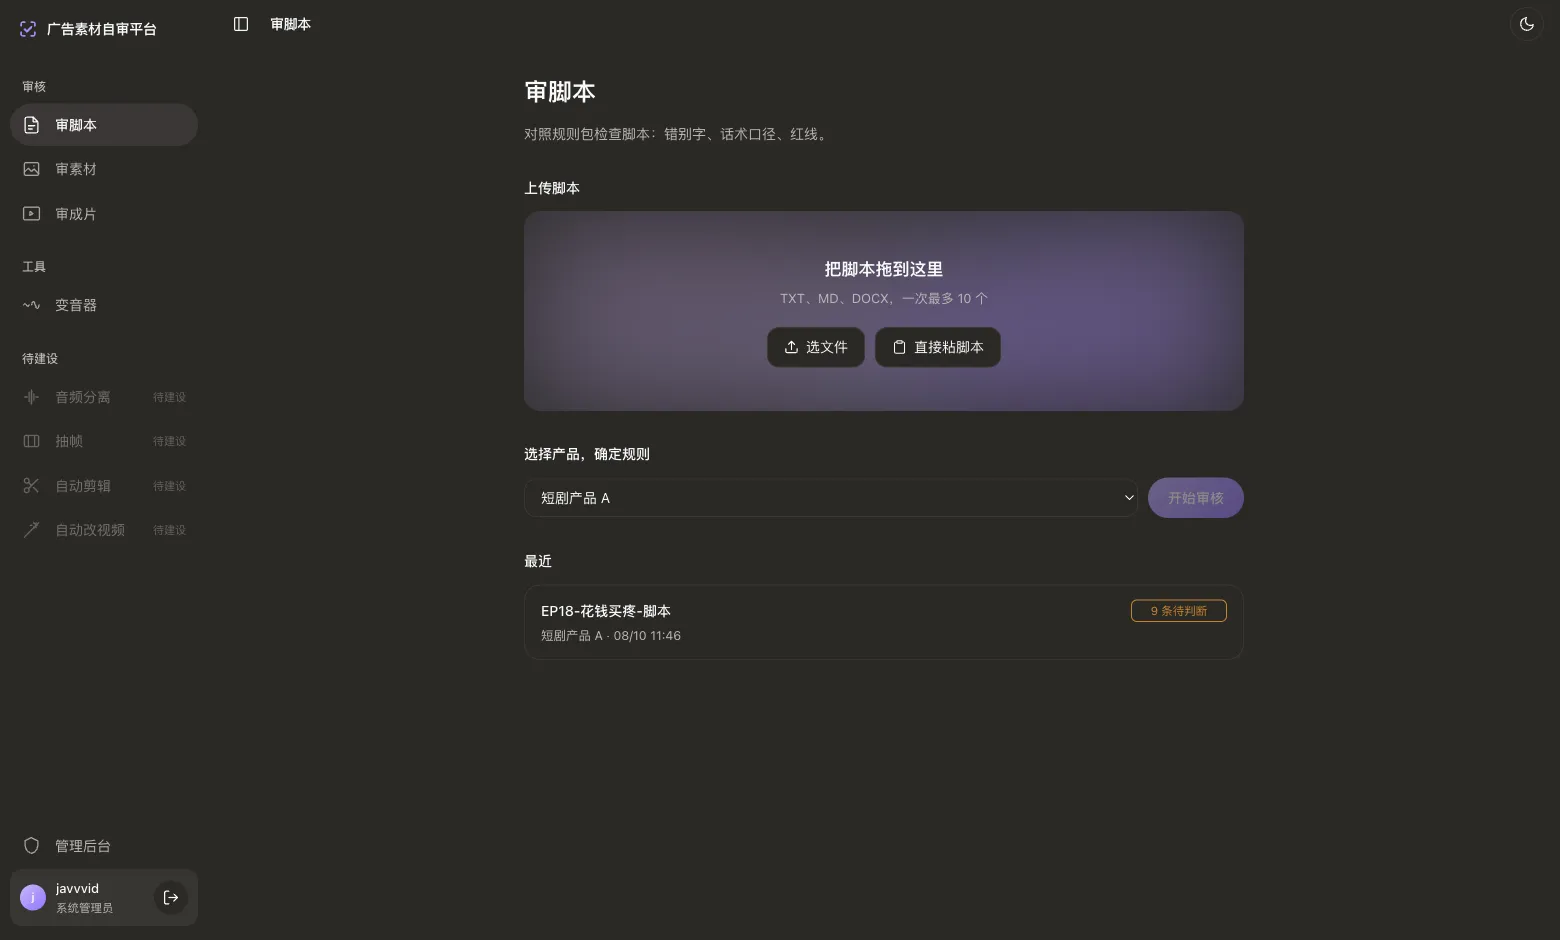
查错别字、话术口径、红线。这一环还是纯文字,改起来成本最低,在这里拦下的问题不会带到后面。脚本可以直接粘进来,不用先存成文件。
审素材 · 制作
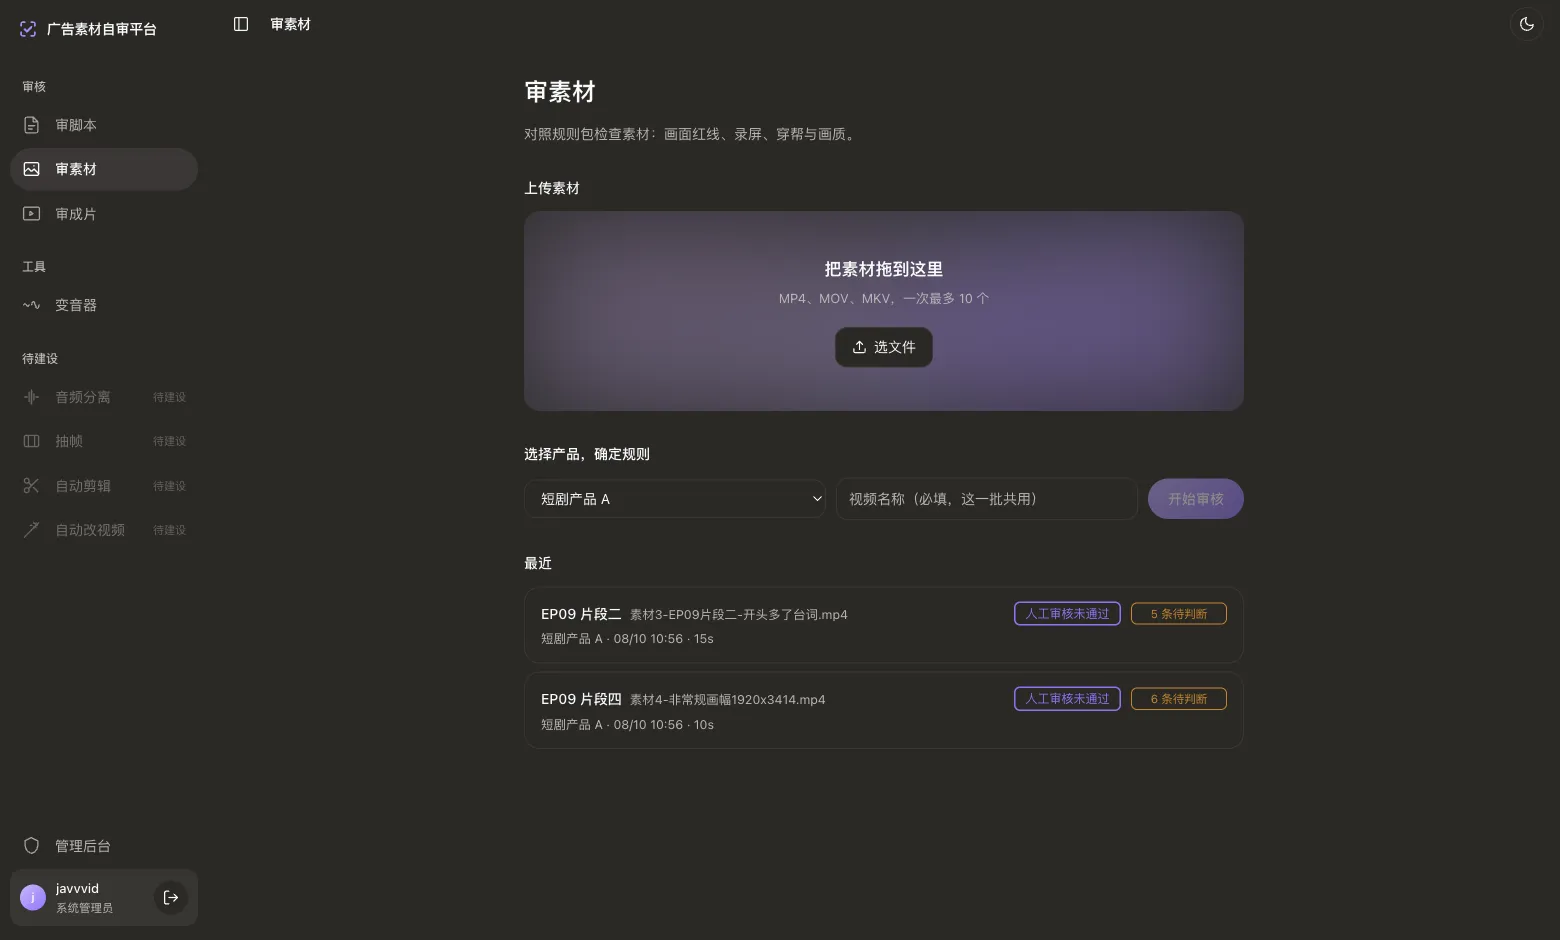
查画面红线、录屏、穿帮、画质。一次最多上传十个,同一批共用一个视频名称——制作交过来的文件名普遍是 0102 这种编号,不填名称在列表里根本分不清谁是谁。
审成片 · 剪辑
交付前的最后一道,字幕、音频、规格、红线全项复核。前两个环节无法覆盖的部分在这一环补齐,剪辑过程中新产生的问题也在这一环检查。
二、一条成片的实测
取一条 79 秒的成片,系统报出 13 处需要判断的问题。
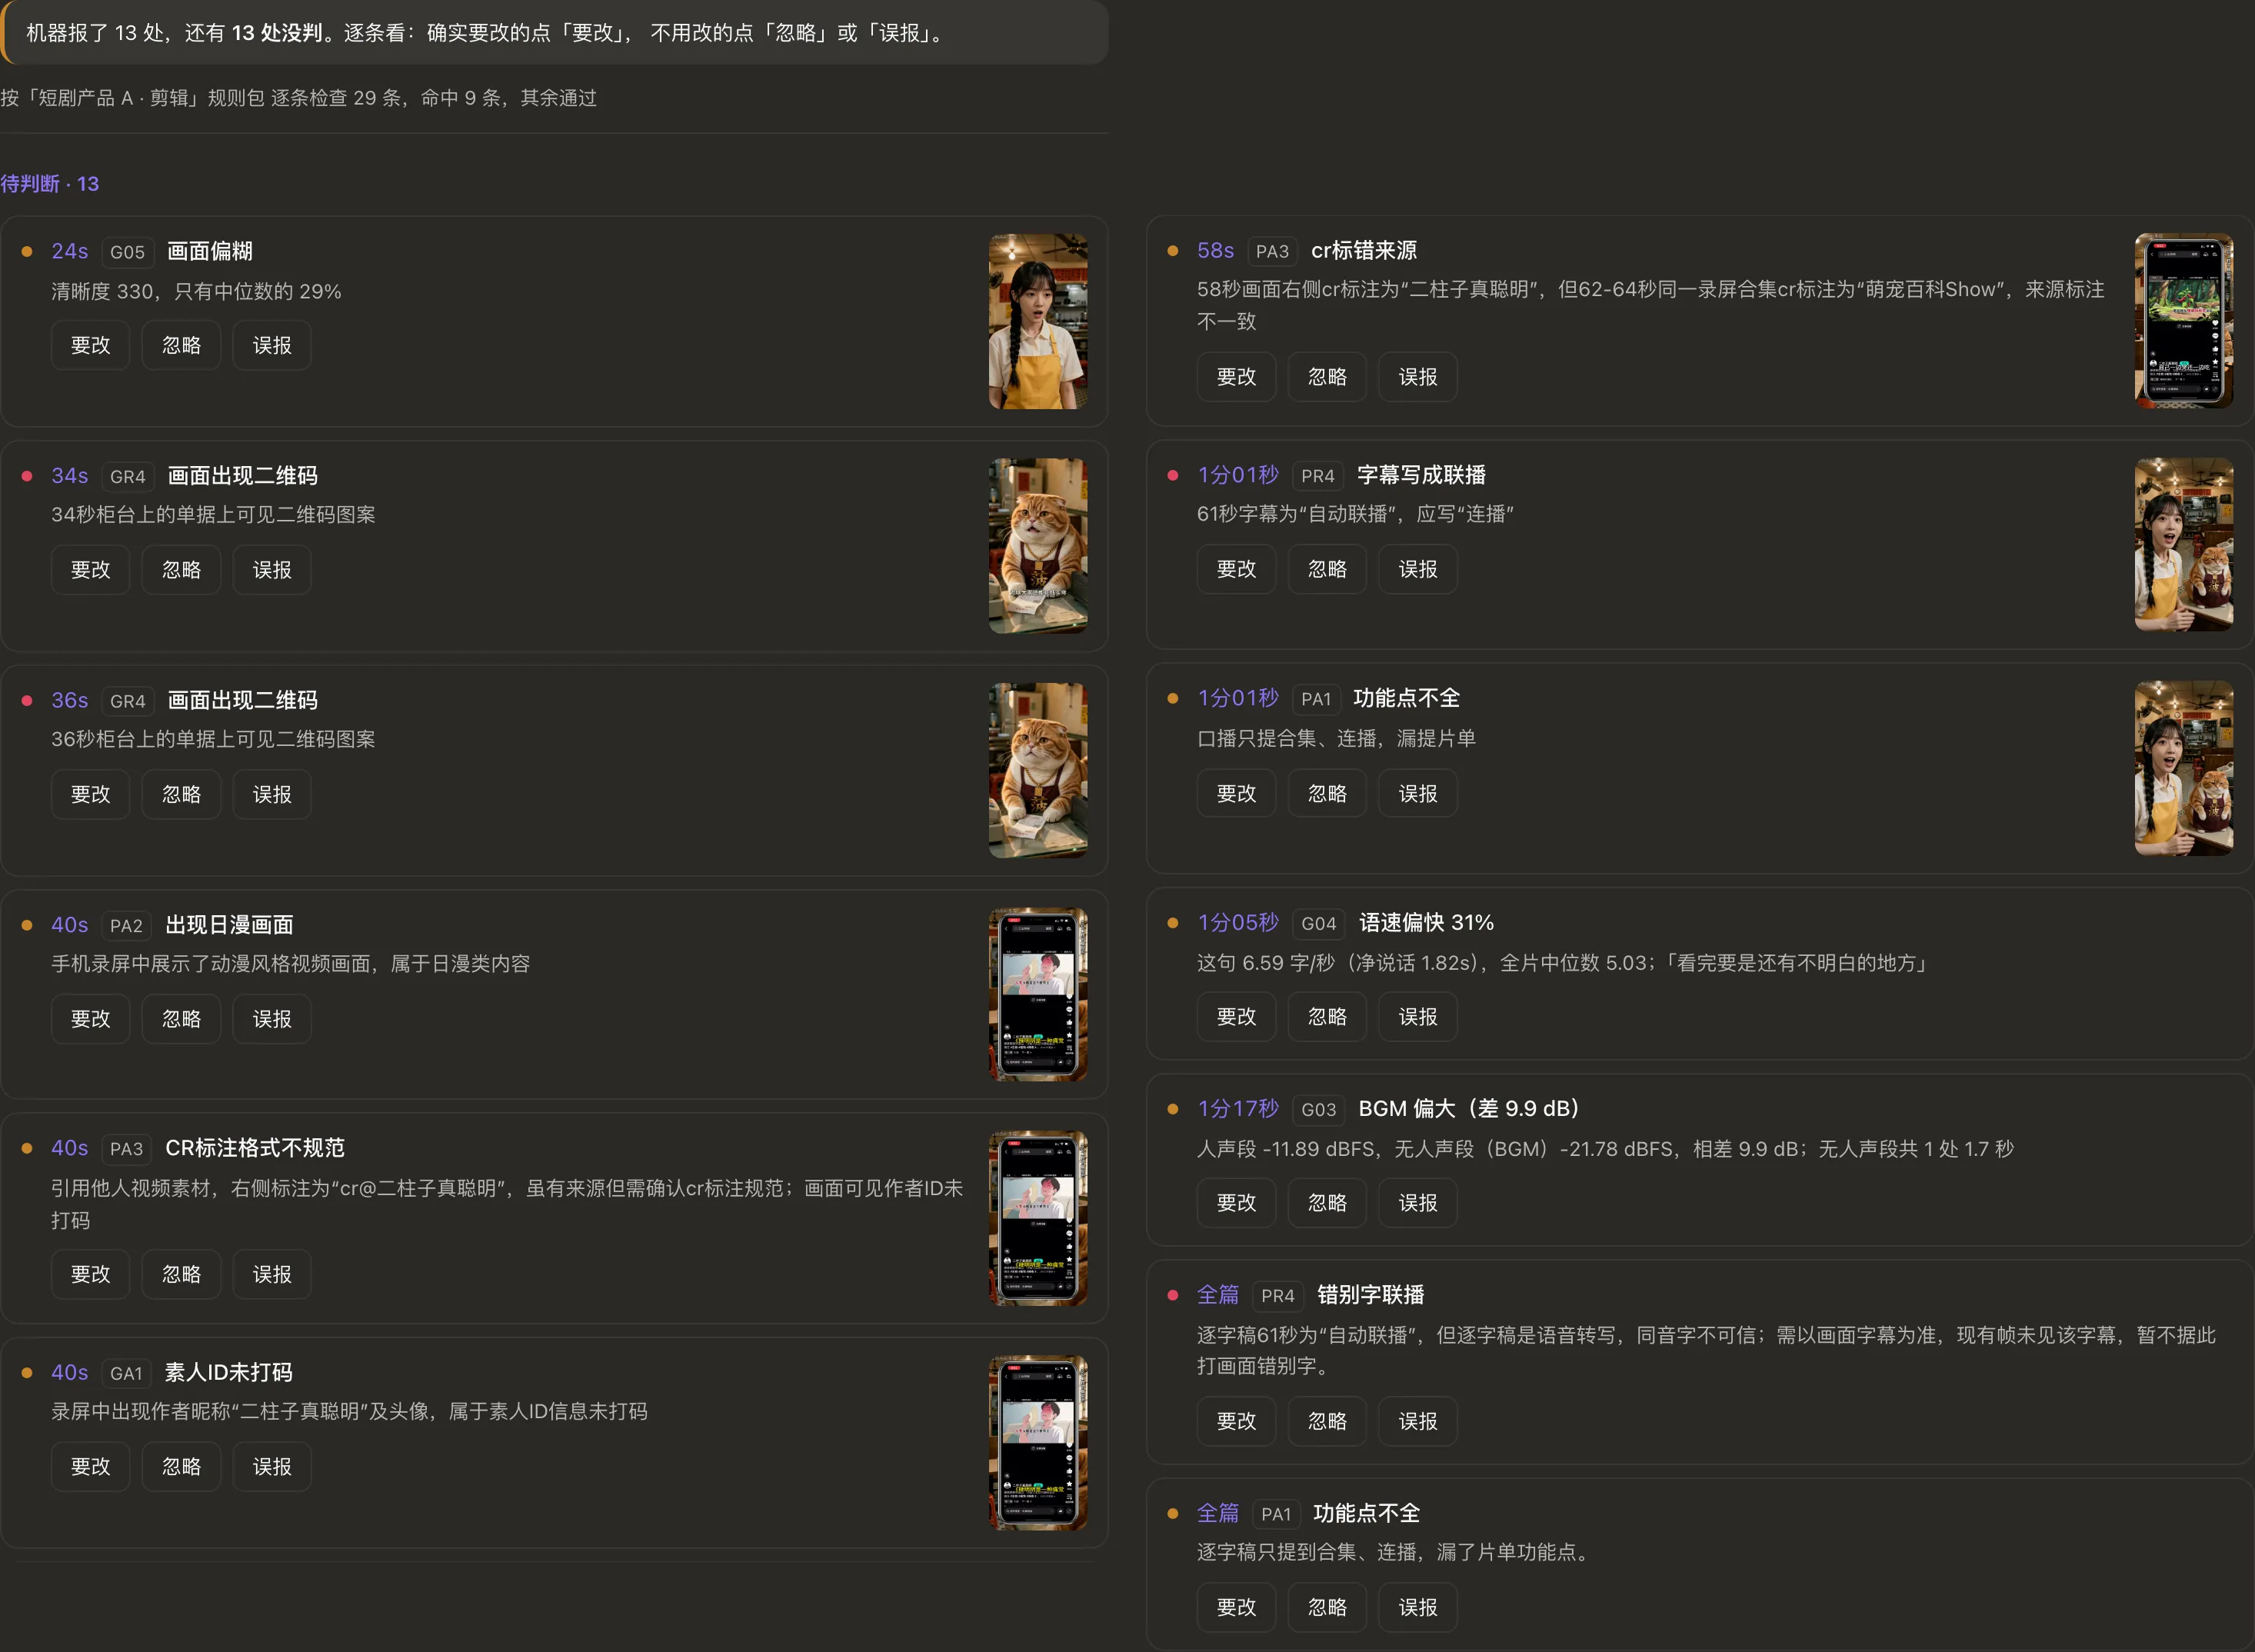
13 处结论全貌:每条带时间码、规则号、证据帧
挑两组说明。
案例一:二维码
系统指出 34 秒和 36 秒,柜台上的单据上有二维码。
放大这一帧看:
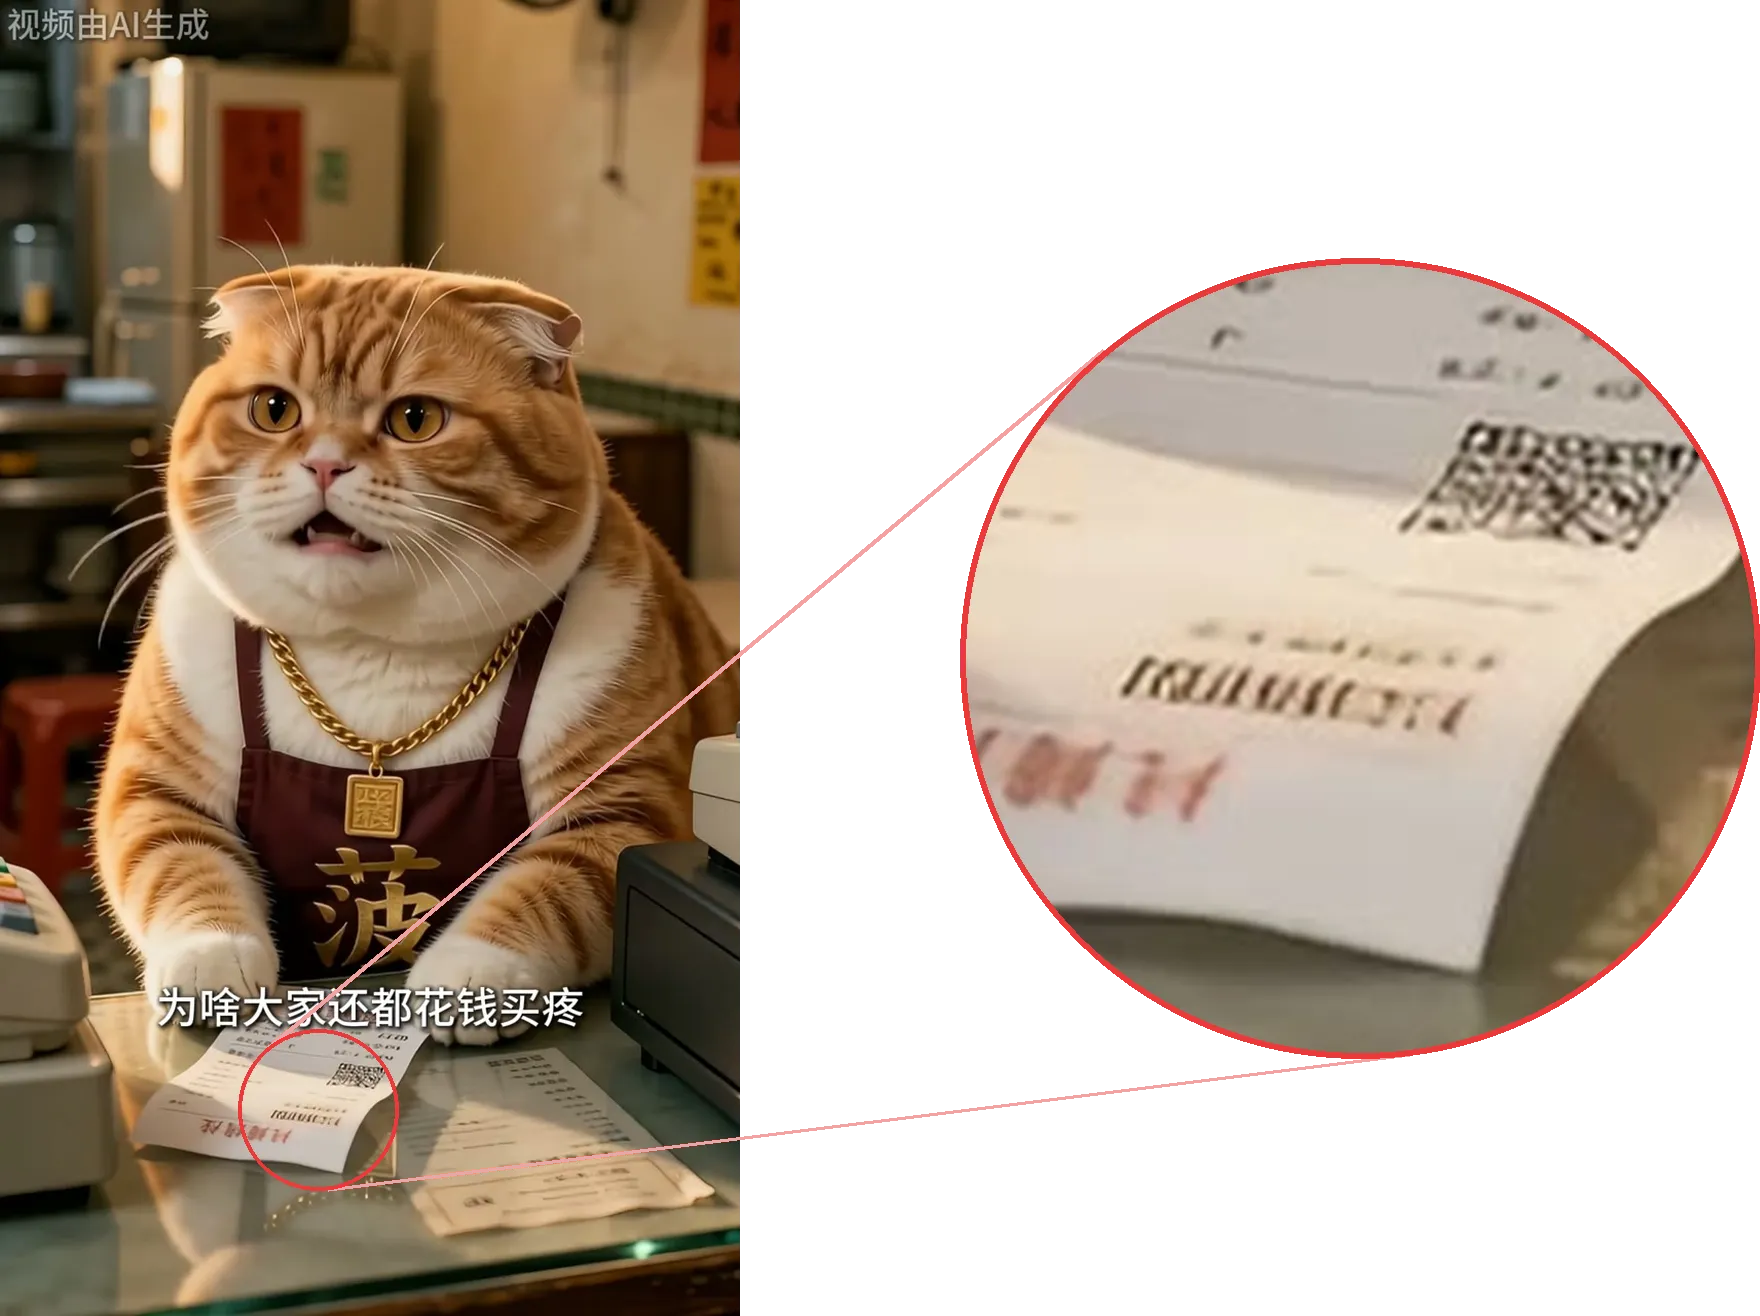
圈出来的是收银台上那张小票,右边是放大
收银台上那张小票,上面印着一个二维码。画面主体是猫和台词——这个二维码的位置和尺寸,靠人自审一般很难发现,最后就把带着错误的成片交上去了。现在系统提示之后直接打码就行。
案例二:CR 标注
系统一共指出三处关于 CR 标注和素人信息的问题。
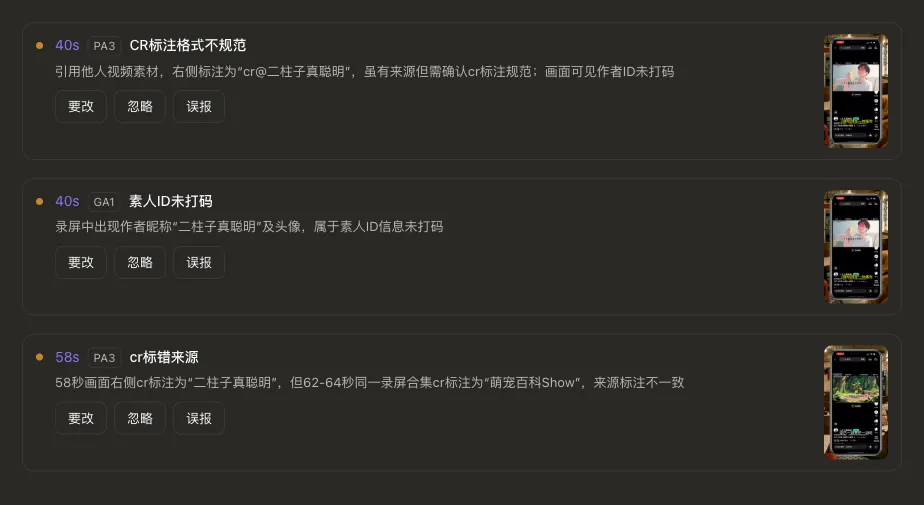
前两条说的是同一帧:引用了他人素材,右侧标了 cr@二柱子真聪明,但格式不规范;同一帧里录屏中作者的昵称和头像没打码。
第三条是 58 秒:系统认为 58 秒 CR 标的是「二柱子真聪明」,62 秒同一段录屏合集标的却是「萌宠百科Show」,前后对不上。
两帧对照:
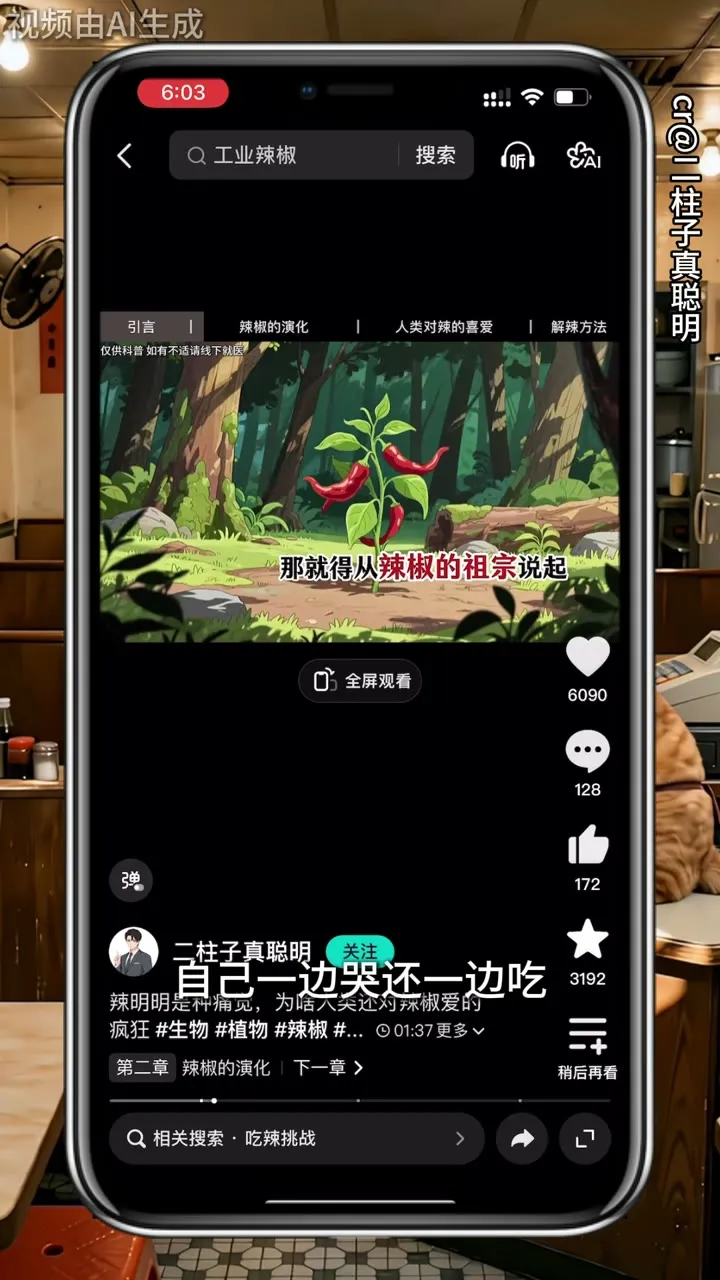
58 秒,署名 cr@二柱子真聪明
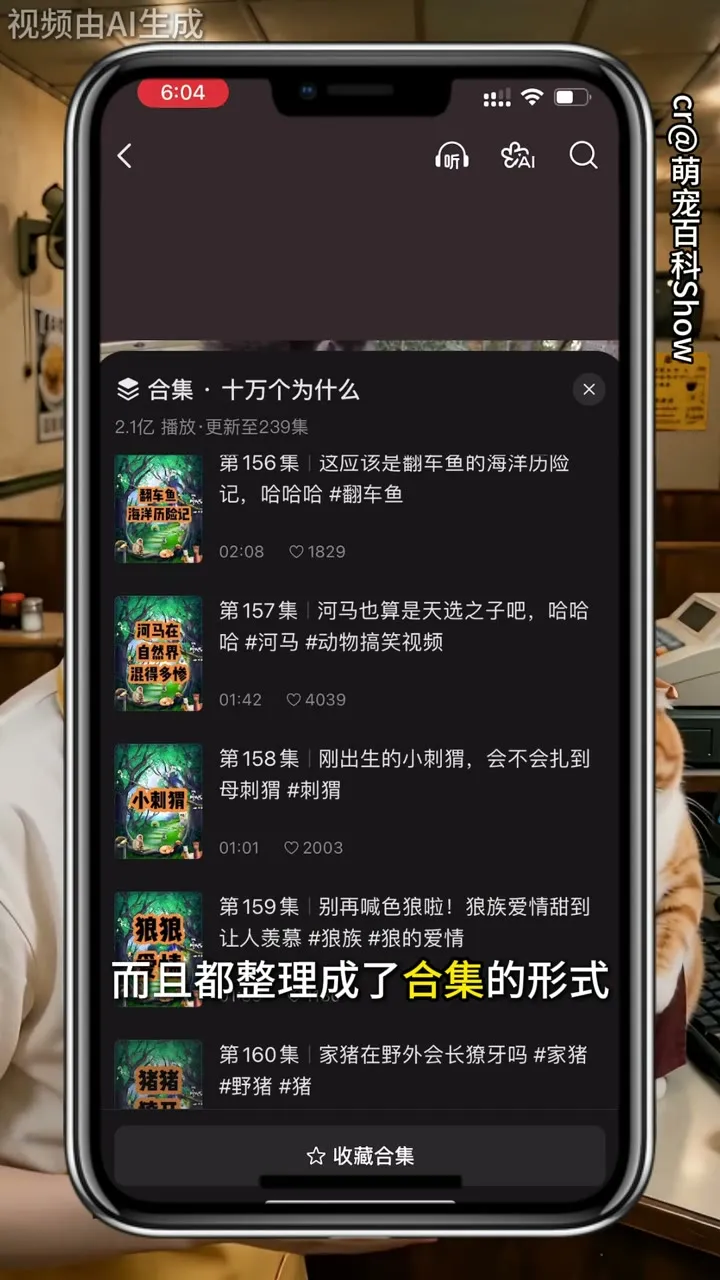
62 秒,署名变成 cr@萌宠百科Show
第三条是一条误报。 58 秒画面是「二柱子真聪明」的辣椒科普,62 秒是「萌宠百科Show」的合集,本来就是两个账号的两段录屏,各标各的来源,剪辑标得没问题。AI 误把两段录屏当成了同一段。
误报是设计出来的,不是缺陷
这种误报会经常发生。但误报是这套系统的重要一环。
取舍很明确:宁可错报 1000 条,不能漏报 1 条。
理由很简单:
- 漏报一条,成片交上去会被人工驳回,甚至直接到客户手里,造成严重损失
- 错报一条,几乎没有损失。员工判断是误报,点一下「忽略」或「误报」,不需要改任何东西
而且「忽略」和「误报」的记录会自动收集,用作调整规则和提示词的依据。误报不是白费的,它是训练信号。
三、系统的核心:规则包
由 AI 设计,交给 AI 用,人工管理。
各环节用什么模型
| 用途 | 模型类型 | 当前选用 |
|---|---|---|
| 规则包设计 | 文本大模型,重长文理解和归纳 | Claude Fable 5 |
| 审片 | 多模态大模型,能读图 | doubao-seed-evolving |
| 审脚本 | 文本大模型 | doubao-seed-evolving |
| 转写台词 | 语音识别 | Whisper turbo |
| 规则维护 | 文本大模型,重长文理解和判断力 | Claude Fable 5 |
| 变音器 | 语音合成 | CosyVoice3 |
每一项功能各用各的模型,都可以在后台自定义更换。规则维护那一项怎么选出来的,写在另一篇里。
为什么不直接用视频识别模型
测下来目前的视频识别失败率偏高。同一条成片,整片直传只报出 2 条,抽帧逐张读报出 11 条,而且漏掉的都是关键且容易发现的问题。
原因是视频进模型送审之前会被压缩,CR 标注、收益数额、AI 标识这些小字糊成一团;抽帧则是原分辨率送审,细节清晰得多。
规则包怎么来的
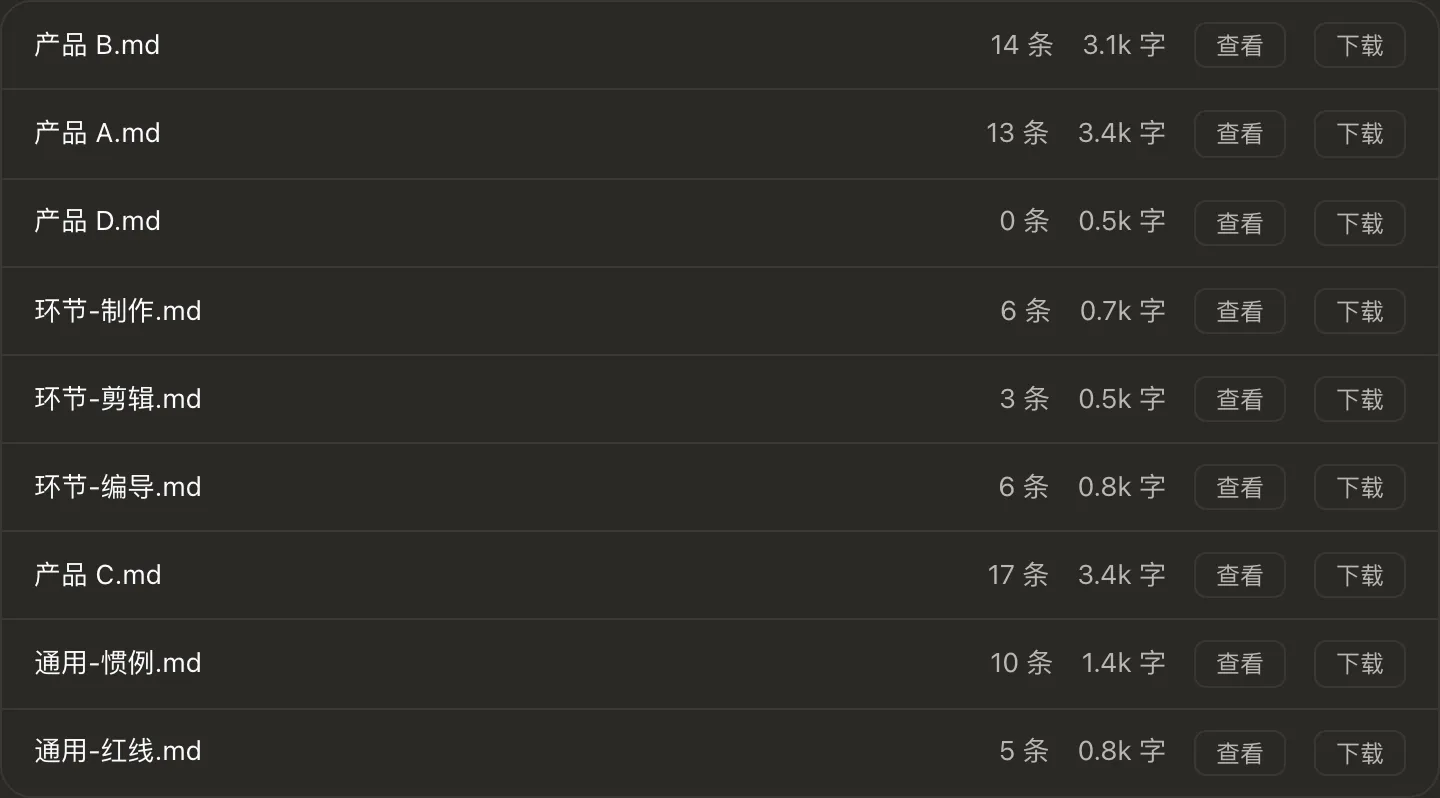
九份规则包,一共 74 条
把产品的红线文档、历史审核记录和审核惯例交给 AI,整理成规则包,再由人工判定生效后使用。
规则包设计成三个轴——通用、产品、环节,每个轴下面挂各自独立的包:
- 通用包:所有产品共同遵守的,比如不能涉军涉政、不能用绝对化话术
- 产品包:产品专属的,比如产品名称的叫法、风险提示
- 环节包:这道工序的审核范围,比如编导环节查脚本的错别字、话术口径、红线
这么分是为了便于管理和增补——加一条新规则时,先想清楚它属于哪个轴。
一条规则长什么样
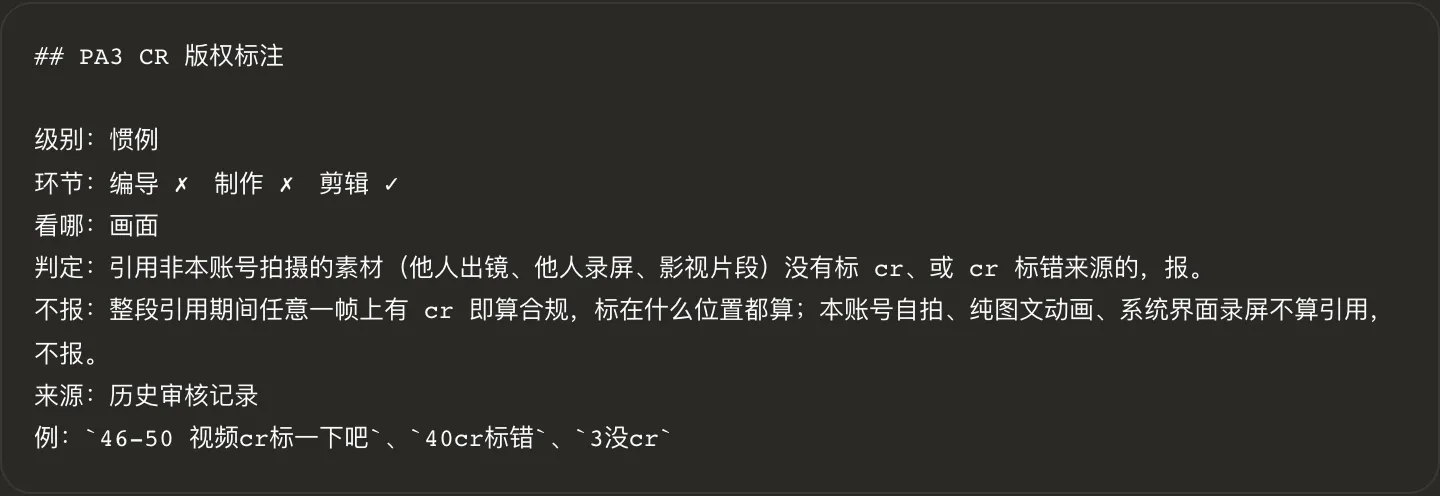
一条规则的原文:第二节案例二那条 CR 标注用的就是它
每个产品对应一份产品包、三份环节包,外加通用红线和通用惯例各一份。
每条规则有自己的编号,两个字母加序号。第一个字母是范围(G 通用 / P 产品),第二个是级别(R 红线 / A 惯例)——所以有 GR 通用红线、GA 通用惯例、PR 产品红线、PA 产品惯例四类。
每条规则固定六个字段:
| 字段 | 作用 |
|---|---|
| 级别 | 红线命中即打回;惯例是反复被驳回但不致命的 |
| 环节 | 三个环节各标 ✓ 或 ✗,送 AI 之前按当前环节裁——编导阶段不会拿成片的标准判 |
| 看哪 | 查画面、字幕还是逐字稿,AI 只在指定范围内检查 |
| 判定 | 什么情况报 |
| 不报 | 什么情况不算问题,用于限制 AI 的过度推断 |
| 来源 | 从产品红线文档来的还是从历史审核记录来的,改的时候能追溯出处 |
「不报」这个字段是整套设计里最关键的一个——没有它,AI 会把一切沾边的东西都报上来。
四、审核流程
以剪辑环节的成片自审为例,走一遍完整流程。
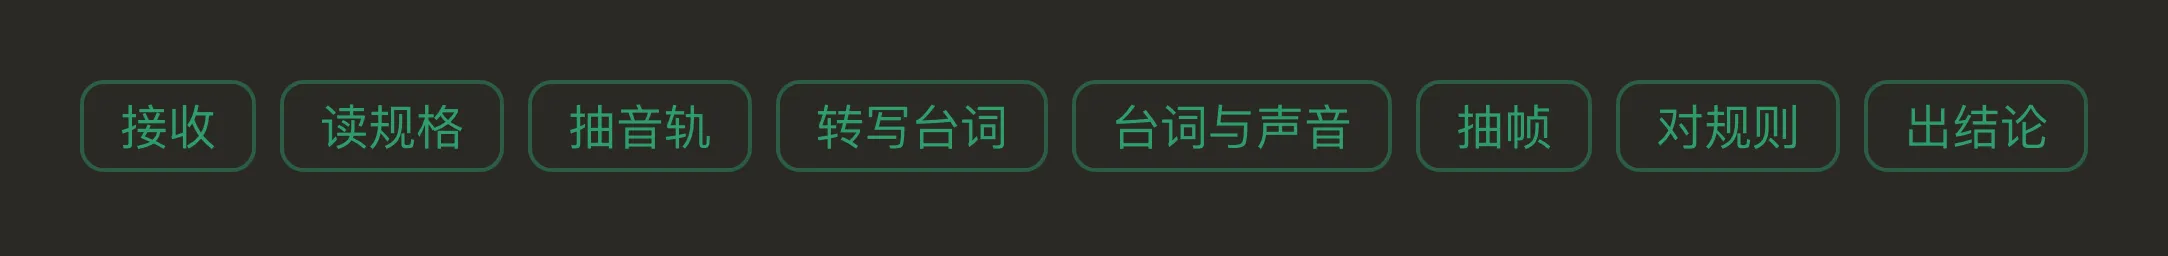
审核的八个步骤
上传:剪辑上传成片、选对应产品,点开始审核。
准备(接收 → 读规格 → 抽音轨 → 转写台词 → 台词与声音 → 抽帧):系统把成片拆成 AI 能判定的素材——视频规格、带时间轴的逐字稿、原分辨率的帧(每秒一张打底,关键处补抽,平均约 1.3 张/秒)。
对规则:把规则包连同这批帧和逐字稿一起交给审核 AI,逐条核对。
出结论:每条写明依据哪条规则、第几秒、画面上看到了什么,并附上那一帧。
一条 79 秒的成片,从上传到出结论约七十秒。
自审和修改
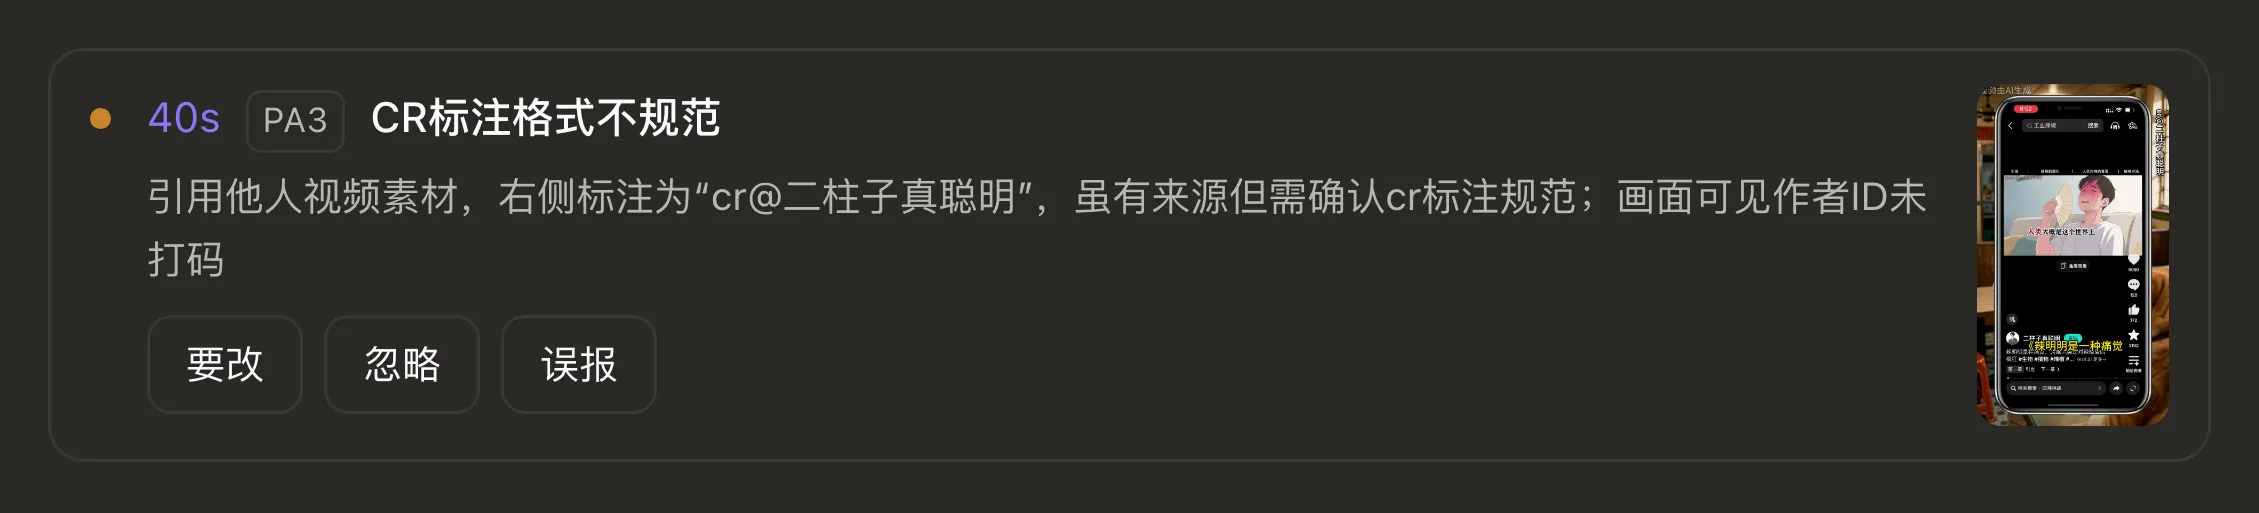
一条结论:时间码、规则号、依据,右侧是 AI 截的证据帧
看结论:每条都写清楚第几秒、依据哪条规则、看到了什么,右边配那一帧。点一下时间戳,左边视频直接跳到那一秒开始播,不用手动拖时间轴找。
逐条判:每条下面三个按钮——要改 / 忽略 / 误报,剪辑自己判断。
修改:判完之后页面顶上汇总成「要改 3 处:12s、35s、48s」,位置一次列全。
再提交:改完提交人工审核。
五、规则会自己进化
规则包不是写死的,从漏判和误判两个方向持续修正,用得越久越准。
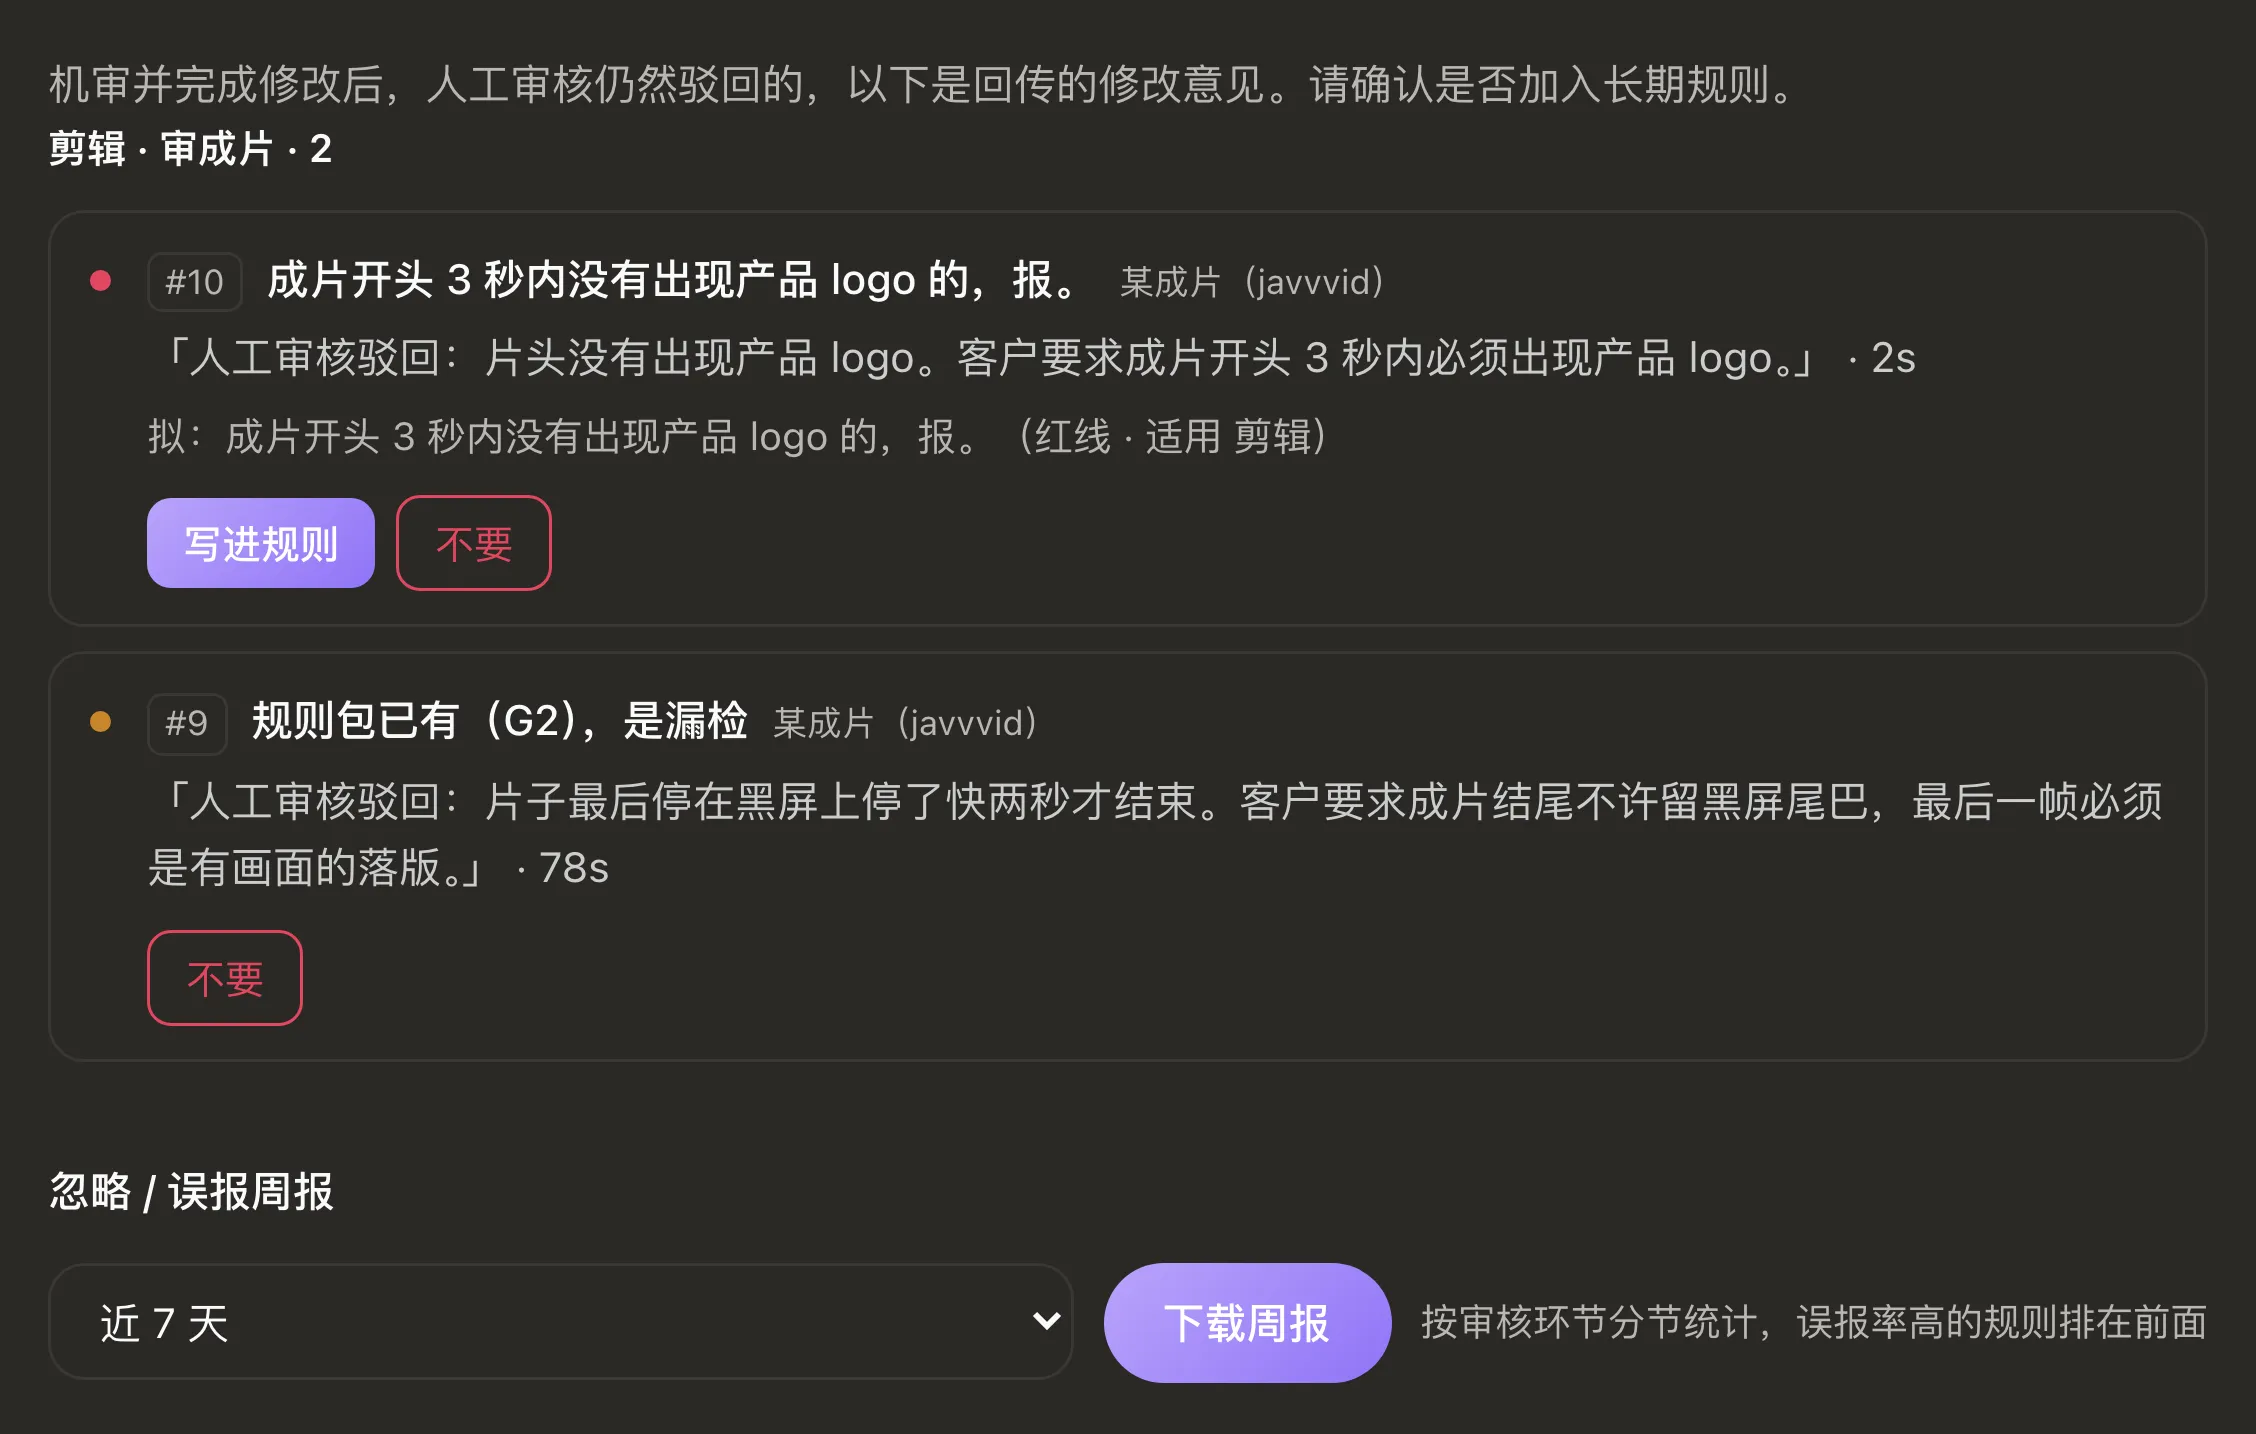
回传的意见由 AI 拟成草案等人确认;下面是忽略 / 误报周报的导出
方向一:漏判
经过自审和修改后仍被人工驳回的,属于漏判。
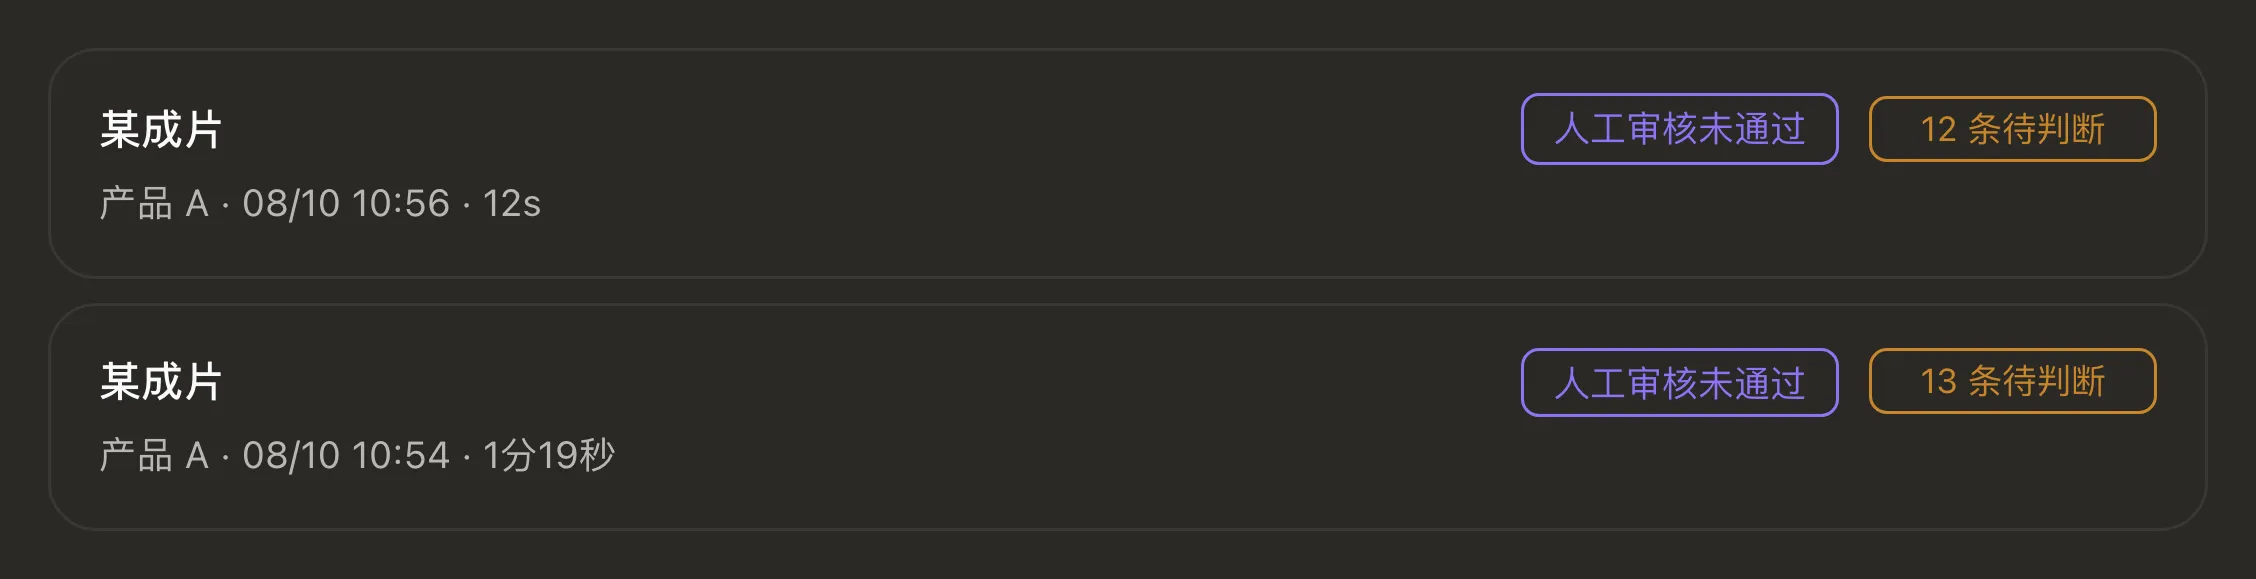
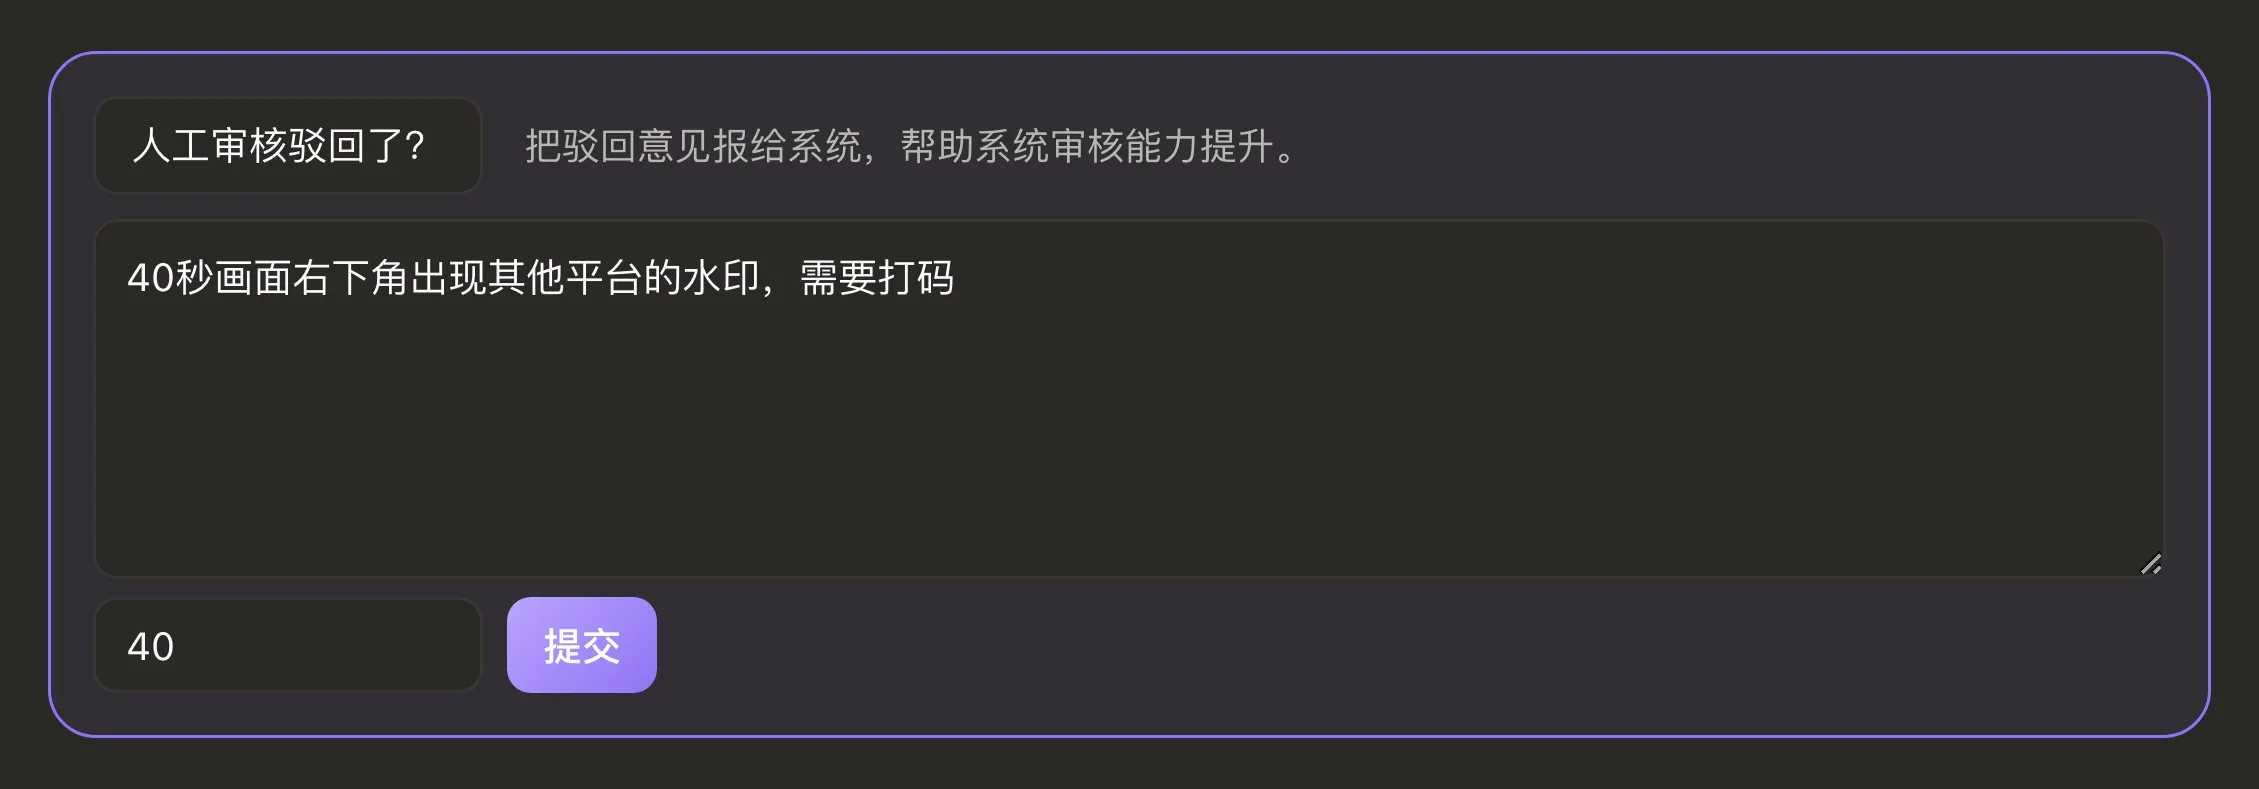
被驳回的记录在列表里标着「人工审核未通过」,点这个标记打开回传表单,把驳回意见原文抄进去,能填第几秒就填。提交之后这条漏判就进到规则草案里等人工判断。
方向二:误判
误判不改规则本身,改的是规则的表述。
每次点「误报」都会被记录,系统按规则统计误报率,周报按误报率排序。排在前面的规则通常是判定口径有歧义的——改写它们的措辞,提高判定精度,减少无谓的判定操作。
这一步的产出物是更清楚的措辞,不是更多的规则。
六、其他生产工具
除审核之外,左侧「工具」区还有一批面向生产环节的能力:
| 工具 | 状态 | 说明 |
|---|---|---|
| 变音器 | 已上线 | 把一段配音换成另一个人的音色,台词、语速、断句不变。模型跑在本机,5 秒配音约 9 秒完成。音色库全员共用,上传者自己管理 |
| 音频分离 | 建设中 | 人声、背景音乐、环境音分轨导出 |
| 抽帧 | 建设中 | 按指定密度导出画面帧 |
| 自动剪辑 | 建设中 | 依据脚本与素材自动粗剪,输出可继续加工的时间线 |
| 自动改视频 | 建设中 | 针对审核结论里的常见问题,自动打码、替换、裁切 |
建设中的功能在左侧同样可见、标注为待建设,完成一项开放一项。
七、后台管理
后台按四级权限开放:系统管理员、项目负责人、组负责人、成员。分的是可见范围与操作权限,三个审核入口对所有人一致。
- 账号管理:新建、停用、删除成员账号,分配所属组。初始密码统一下发,首次登录必须修改,未改的会被标出来。停用立即断开登录但保留记录,删除则连同上传记录一并清除
- 成员自审:按人统计四项——提交次数、未判定条数、判定为忽略或误报的条数、上报的人工驳回次数,按人工驳回次数排序。用来识别没按要求用自审的人
- 规则草案:成员回传的驳回意见经 AI 整理后排在这里等确认。确认后立即写入规则文档生效,不该长期保留的直接丢弃。同一条草案只能处理一次
- 规则管理:查看现有规则包,新建产品并上传产品红线文档(支持图片格式识别),导出忽略与误报周报
- 模型管理:按任务槽位分别指定模型,切换不需要改代码